Simulation d'agent intelligent autonome
Agent Python en trois étapes pour un cours d'IA : classer des pièces industrielles à partir de photos de téléphone (KNN et K-Means écrits à la main), planifier leur réempilement avec STRIPS/PDDL et traverser un labyrinthe aléatoire avec A*.
Projet final individuel d'Intelligence Artificielle I (UNCuyo, 2025).
- Python
- OpenCV
- scikit-learn
- NumPy
- PyQt5
- KNN
- K-Means
- STRIPS / PDDL
- A*
- pygame
Le problème et l'agent
Le sujet demande un agent basé sur des objectifs qui fait trois choses dans l'ordre : reconnaître quatre types de pièces (clous, vis, écrous et rondelles) à partir d'une photo, réordonner les boîtes qui les contiennent en une pile cible et transporter la pile à travers une salle jusqu'à un point cible par le chemin le plus court.
J'ai spécifié l'agent avec le tableau PEAS (performance, environnement, actionneurs, capteurs) et traité chaque étape comme un problème à part. Les trois étapes sont des scripts séparés : elles partagent le fil conducteur (les noms des classes deviennent les objets du planificateur) mais aucun code ne les relie, et il n'y a pas de robot physique.
Étape 1 — Photos et jeu de données
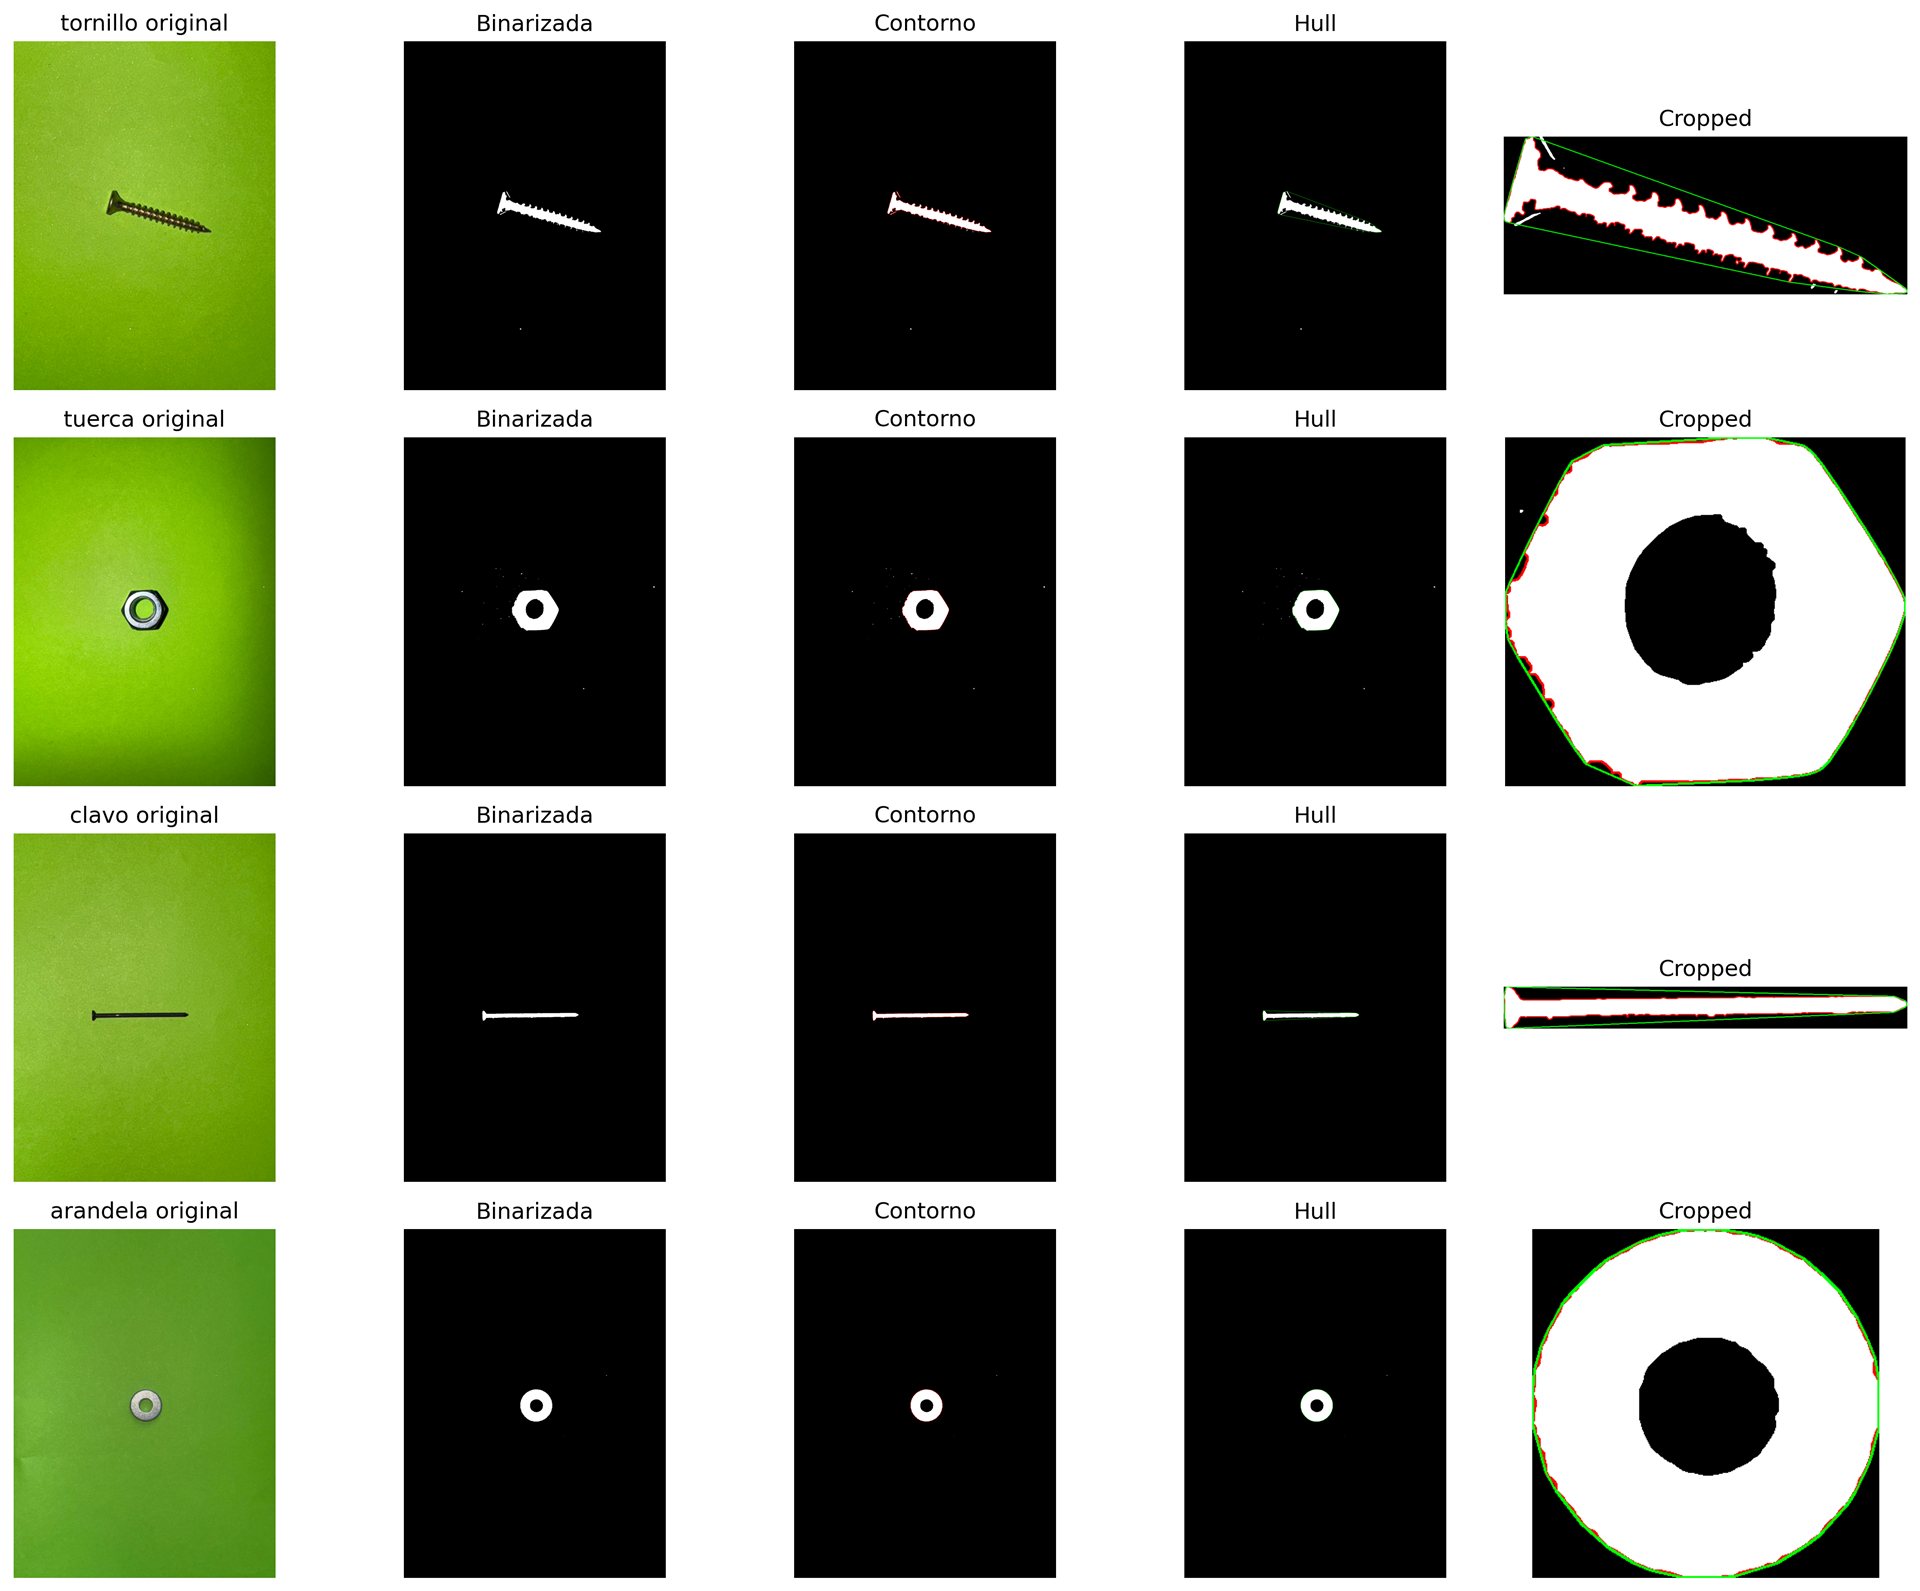
Toutes les photos ont été prises avec un téléphone, flash activé, sur un carton vert uniforme. Ainsi la pièce est la seule chose qui n'est pas verte et la segmentation reste simple. Le prix à payer est la robustesse : la chaîne attend ce fond et ne fonctionnerait pas sur une table encombrée.
J'ai pris environ 30 photos par classe (clous, vis, écrous, rondelles), 120 au total, et fait tourner les pièces asymétriques (clous et vis) entre les prises pour que le résultat ne dépende pas de l'orientation. J'ai aussi gardé des séries supplémentaires prises à l'université (vert brillant, vert mat, table d'examen).
Étape 1 — Traitement d'image
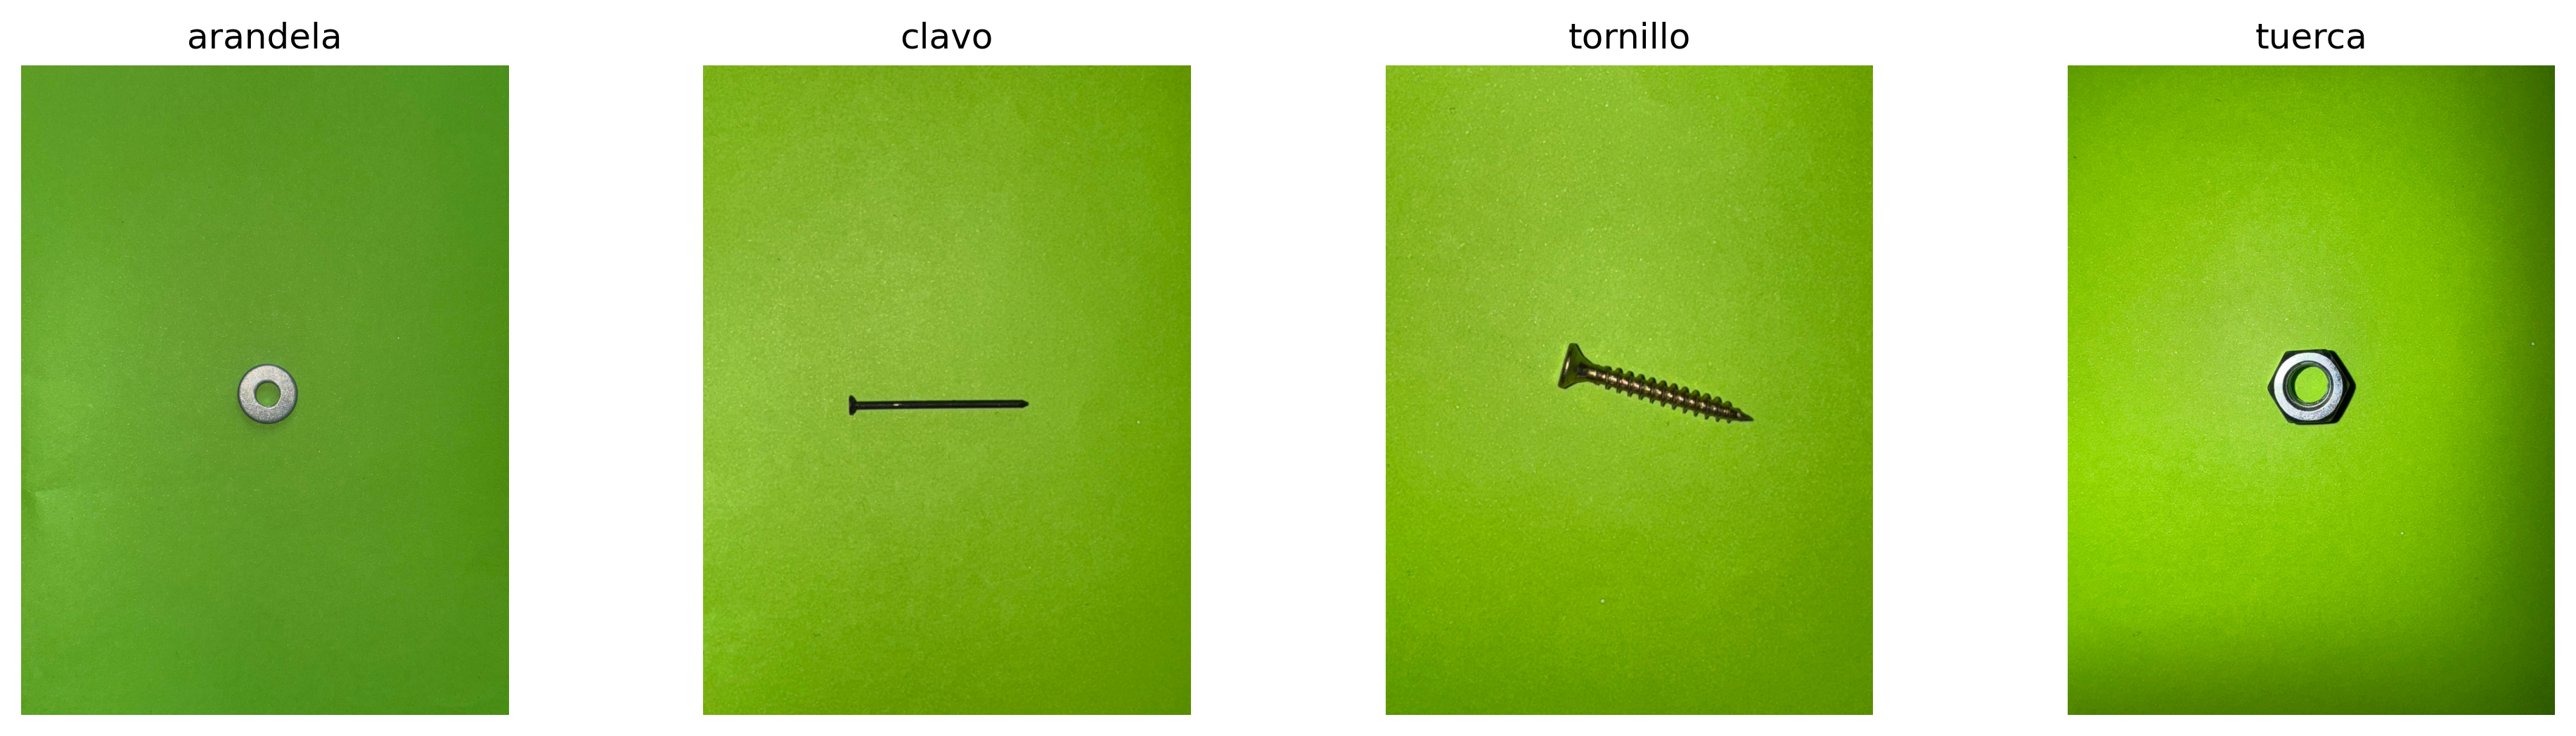
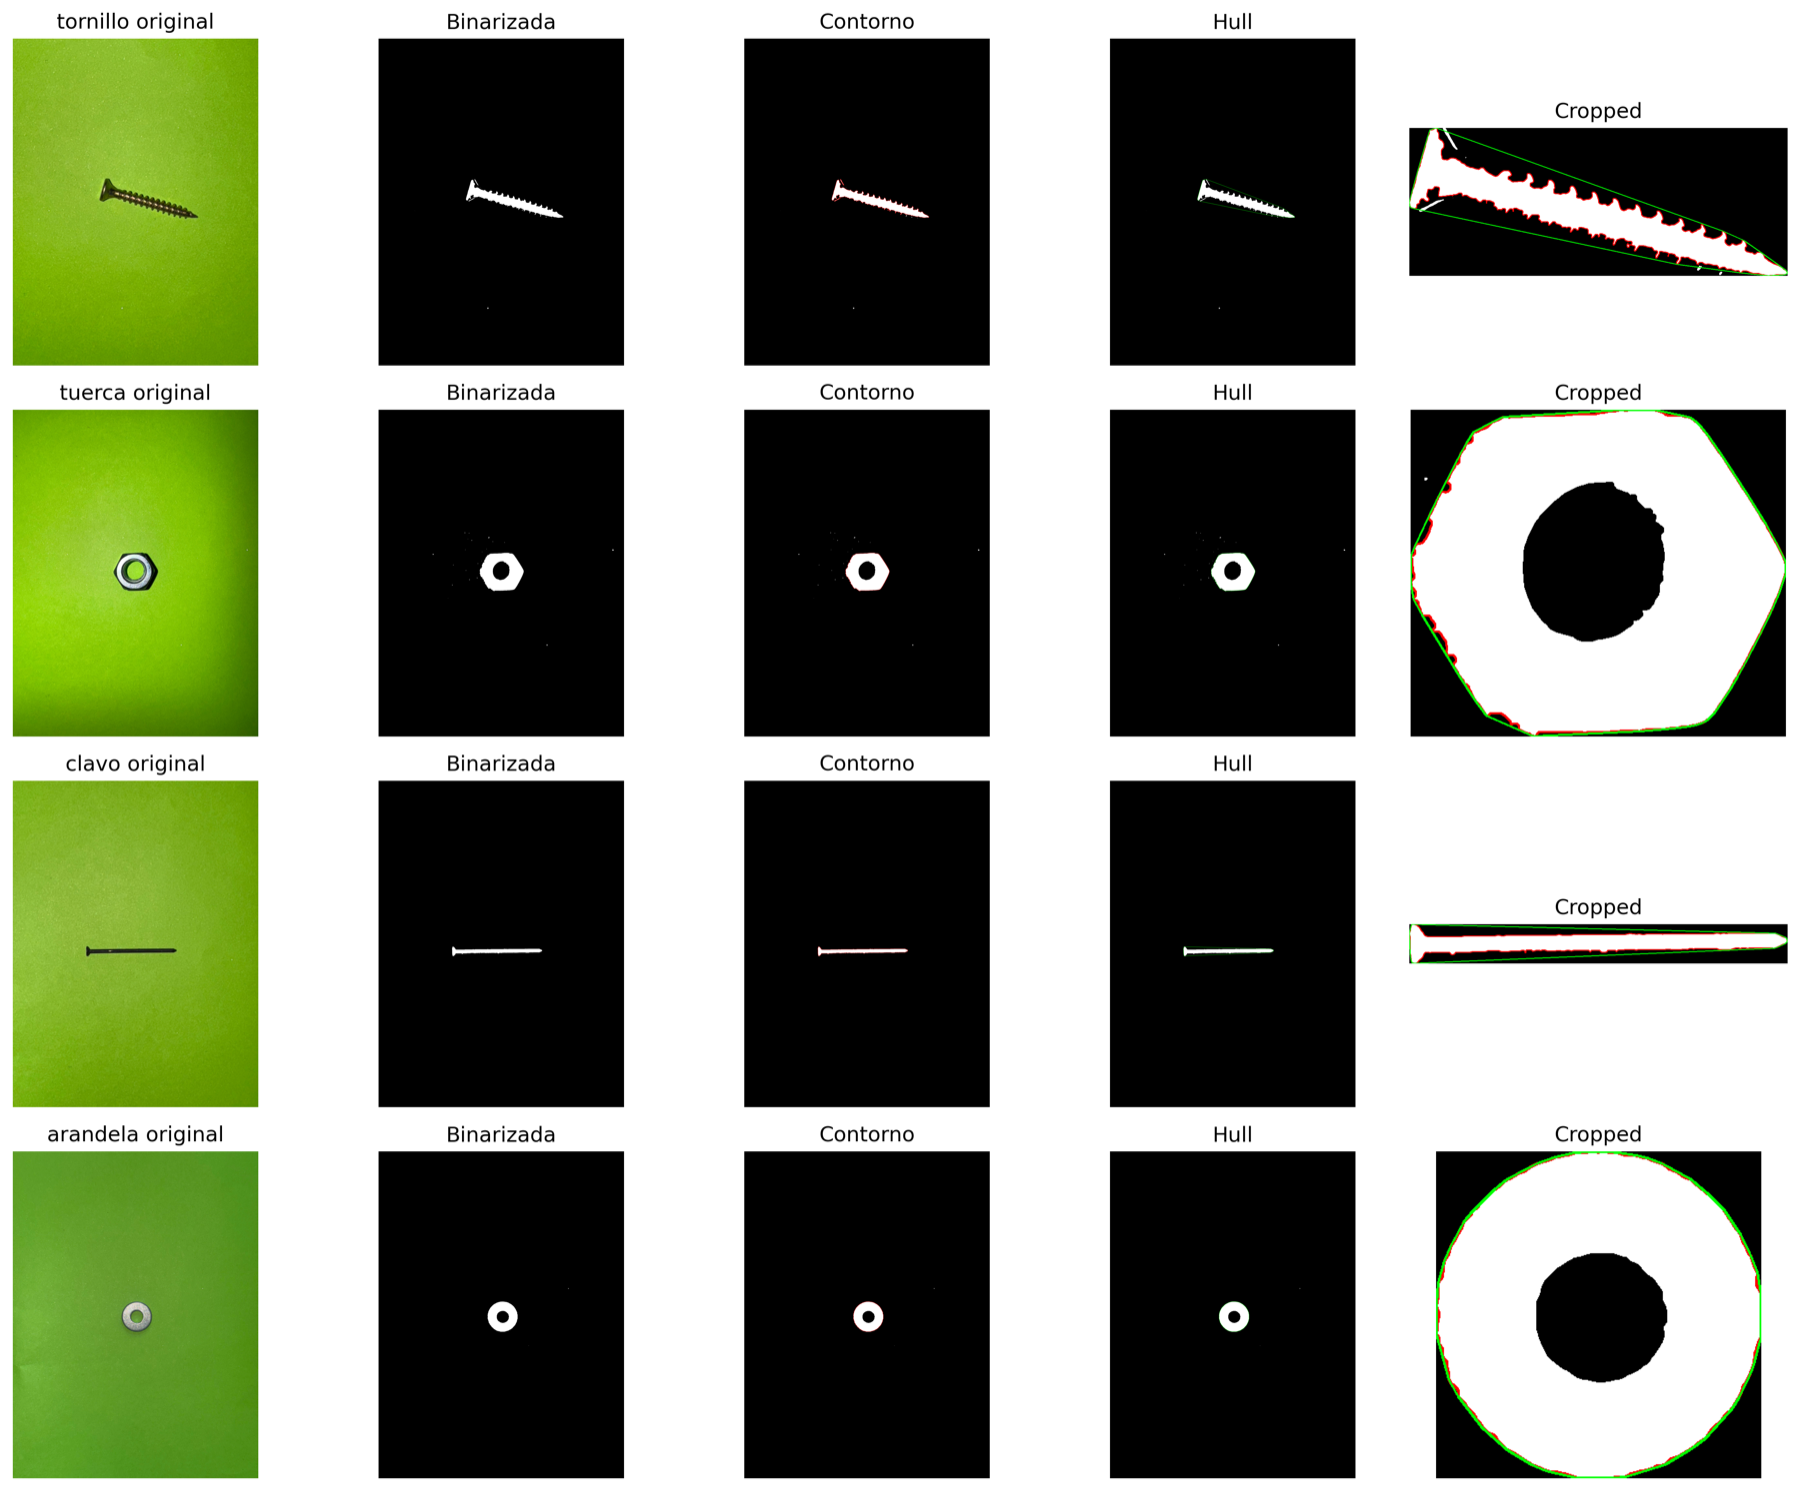
Toute la chaîne se trouve dans preprocess.py et suit l'ordre dans lequel je l'ai construite :
- HSV : la couleur moyenne de la photo est prise comme fond et sert à construire une plage de couleurs ; le masque est inversé pour garder la pièce et noircir le fond.
- Ouverture avec un noyau elliptique pour supprimer les petites taches.
- Niveaux de gris, filtre médian et seuil de Li pour obtenir une image binaire de la pièce.
- Fermeture et remplissage (flood fill) pour combler les petits trous internes, en gardant le plus grand trou pour que les écrous et les rondelles conservent leur centre.
- Contours : on garde les trois plus grands (au moins 100 px de long), on recadre la boîte englobante, une seconde ouverture (15×15) nettoie les bords et seul le plus grand contour survit. On calcule son enveloppe convexe pour l'étape suivante.
Étape 1 — Caractéristiques
À partir du contour et de l'enveloppe de chaque pièce, je calcule 17 valeurs (features.py) : les sept moments de Hu de l'enveloppe (en échelle log) plus l'aire, le périmètre, la circularité, la circularité de l'enveloppe, la solidité, la convexité, le rapport d'aire au cercle, le rapport d'axes, l'excentricité et le rapport périmètre/aire. Tout est standardisé avec StandardScaler avant l'analyse.
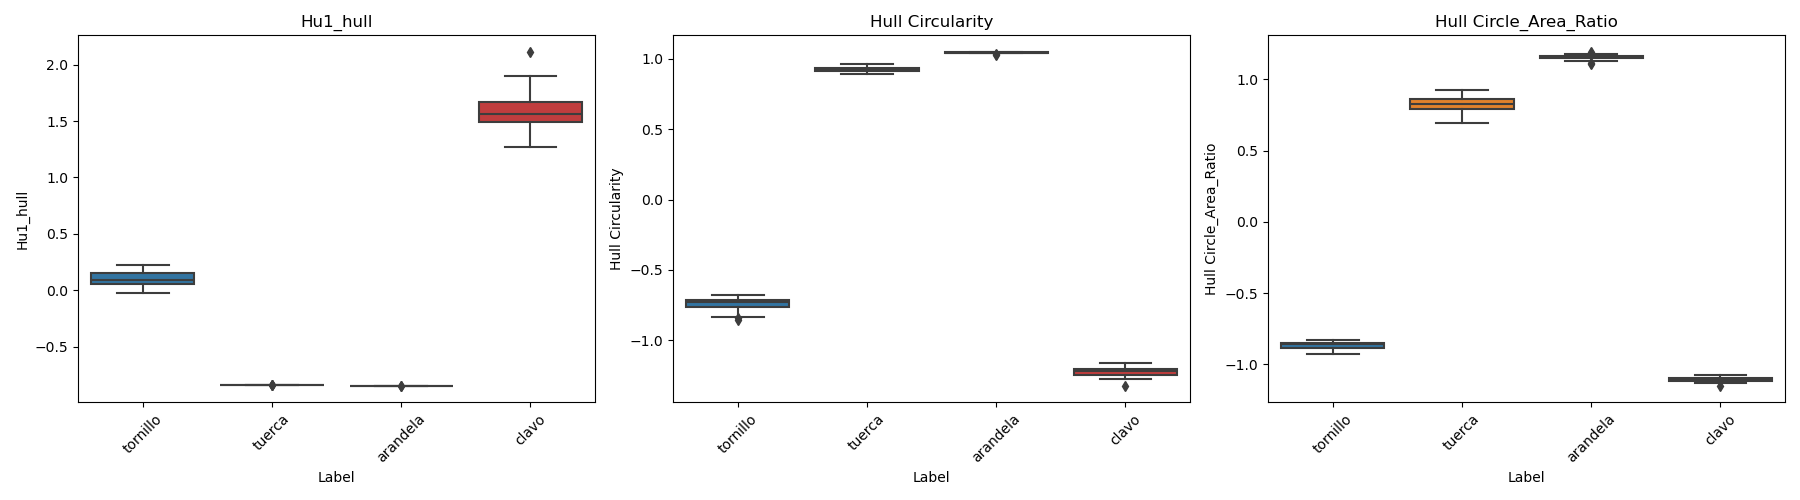
Les boîtes à moustaches par classe montrent quelles caractéristiques séparent les quatre pièces et lesquelles non. Par exemple, écrous et rondelles ont presque le même Hu1 : cette caractéristique seule ne suffit pas à les distinguer.
Étape 1 — Choix de trois caractéristiques
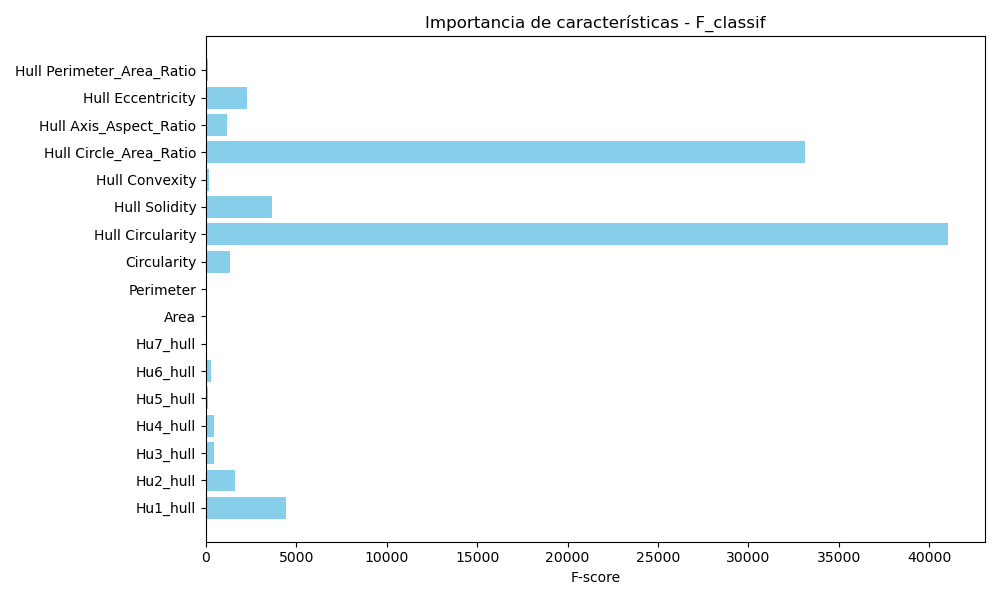
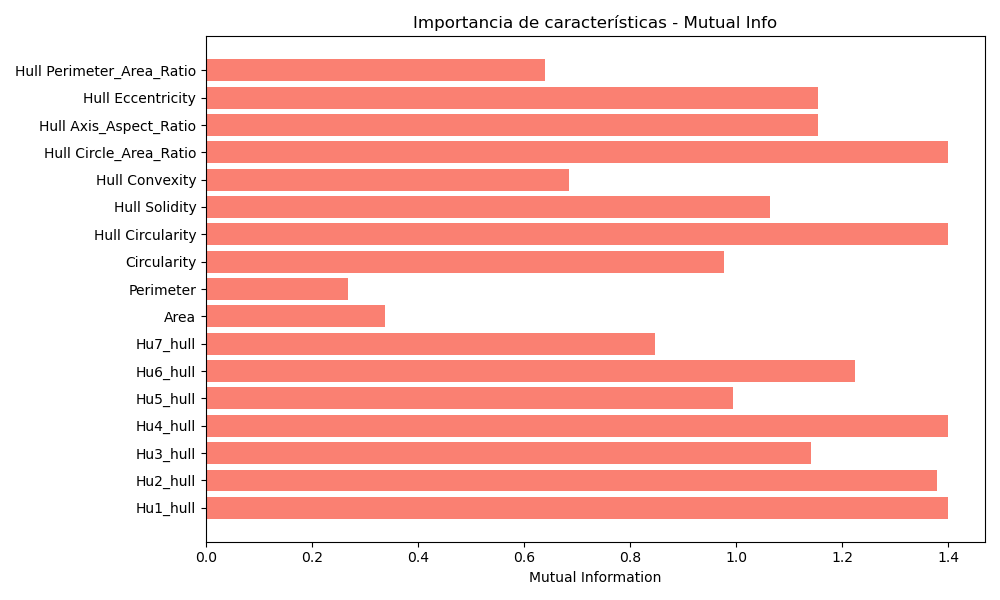
J'ai classé les caractéristiques avec deux scores univariés : le score F de l'ANOVA (f_classif) et l'information mutuelle (mutual_info_classif). J'ai retenu le Hu1 de l'enveloppe, la circularité de l'enveloppe et le rapport d'aire de l'enveloppe au cercle.
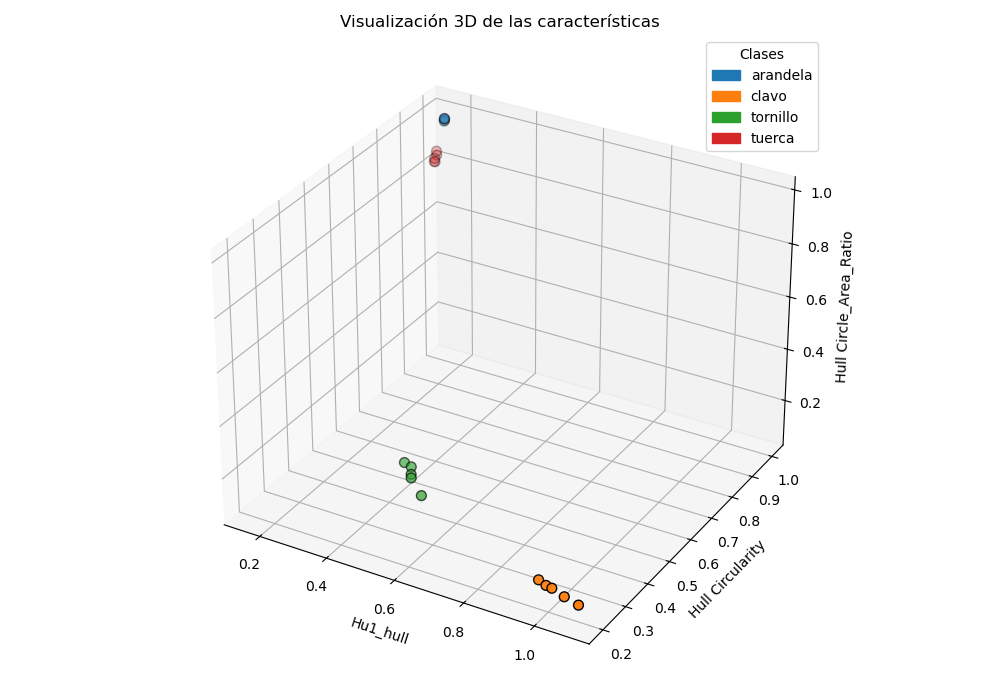
La solidité de l'enveloppe a en fait un score F plus élevé que Hu1 (1205,7 contre 832,7) mais une information mutuelle bien plus faible (0,90 contre 1,35), et elle recoupe les deux caractéristiques de type circularité, donc je l'ai écartée. Avec trois caractéristiques, je peux aussi afficher chaque photo en 3D et voir les classes avant tout entraînement.
Étape 1 — KNN et K-Means from scratch
Les deux algorithmes sont écrits à la main avec NumPy dans models.py ; scikit-learn ne sert que pour le scaler, les scores des caractéristiques et la validation croisée.
- KNN : distance euclidienne, k = 7, vote majoritaire.
- K-Means : 10 initialisations aléatoires, en gardant celle de plus faible variance intra-cluster ; un cluster vide garde son centroïde précédent. Comme K-Means ne connaît pas les étiquettes, j'associe clusters et classes avec l'algorithme hongrois (linear_sum_assignment) sur la matrice de confusion pour mesurer sa précision.
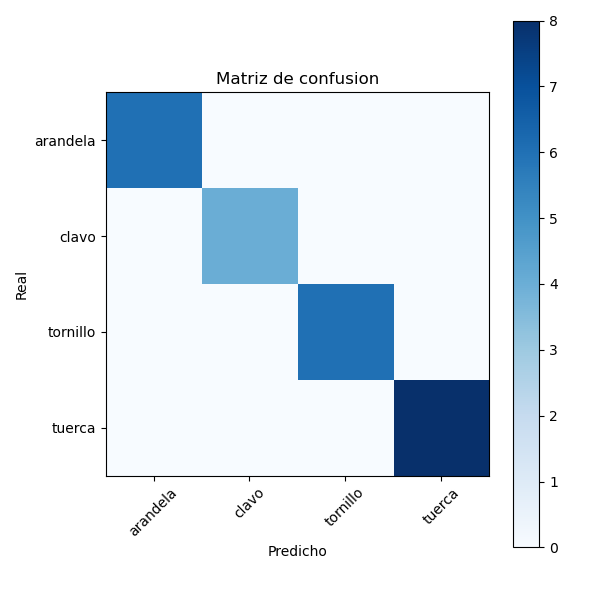
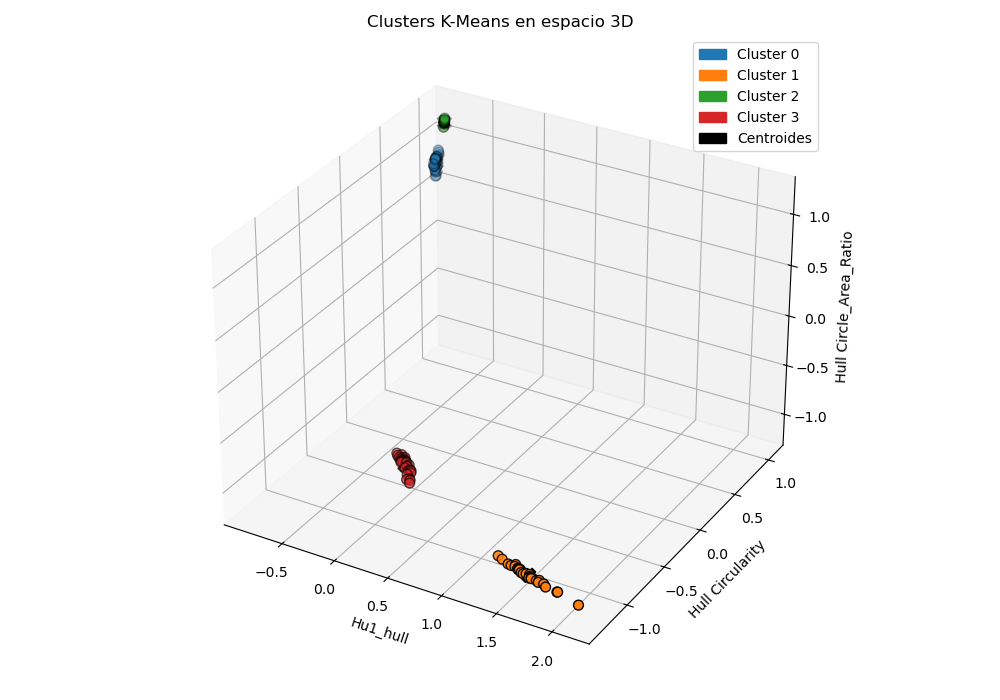
Avec une séparation 80/20 des 120 photos, KNN a classé correctement toutes les photos de test (matrice de confusion diagonale) ; K-Means a obtenu un score plus faible. Dans les clusters 3D, deux d'entre eux se chevauchent presque, ce qui correspond à des écrous et des rondelles aux caractéristiques proches. Ce 100 % vient de photos prises dans les mêmes conditions que l'entraînement, donc il dit peu de chose sur d'autres fonds.
Étape 1 — Application de bureau
Pour essayer le classifieur, je l'ai encapsulé dans une application PyQt5 séparée en modèle, vue et contrôleur. On choisit le dossier d'entraînement, on entraîne, on choisit une photo et on voit le masque traité avec son contour et son enveloppe, les trois valeurs, le point affiché parmi les données d'entraînement, la prédiction KNN avec les étiquettes de ses 7 voisins et sa précision en validation croisée, et la prédiction K-Means.
Étape 2 — Planification STRIPS
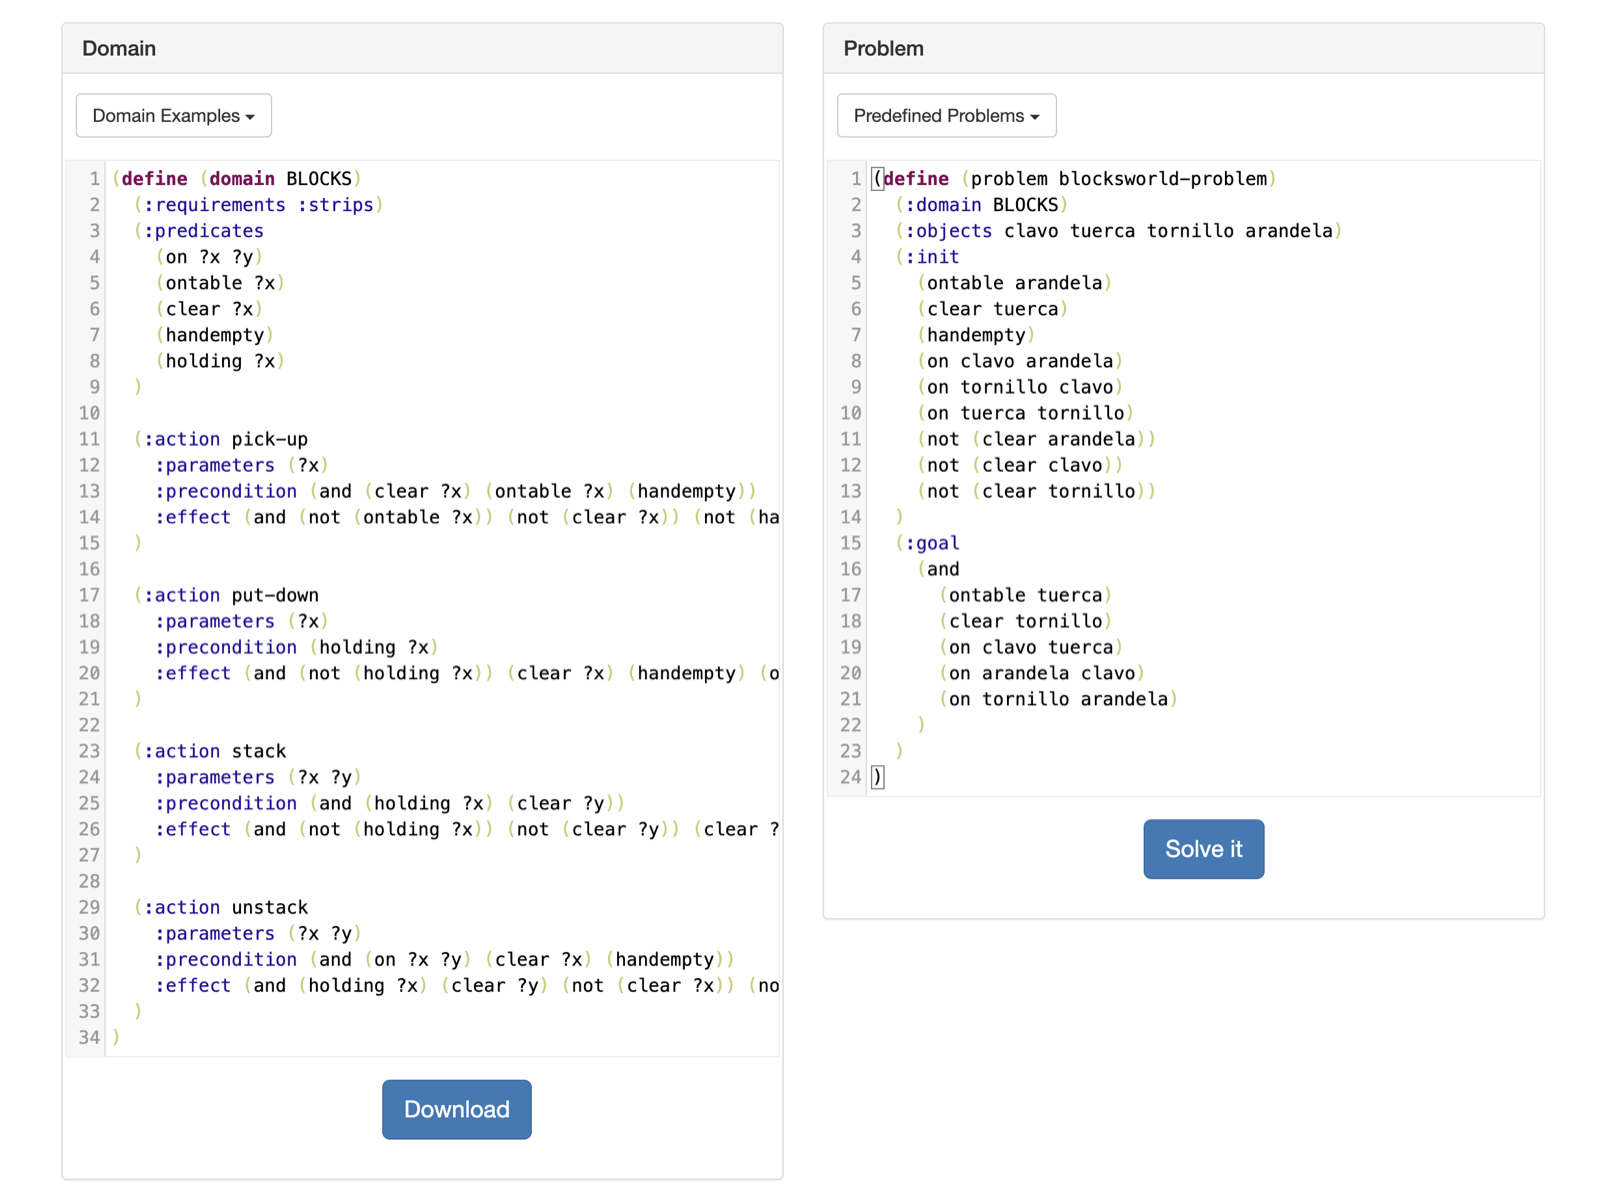
J'ai modélisé les boîtes comme un monde de blocs : les quatre pièces sont les blocs, avec les prédicats on, ontable, clear, handempty et holding, et quatre actions (pick-up, put-down, stack, unstack), chacune avec ses préconditions et ses effets.
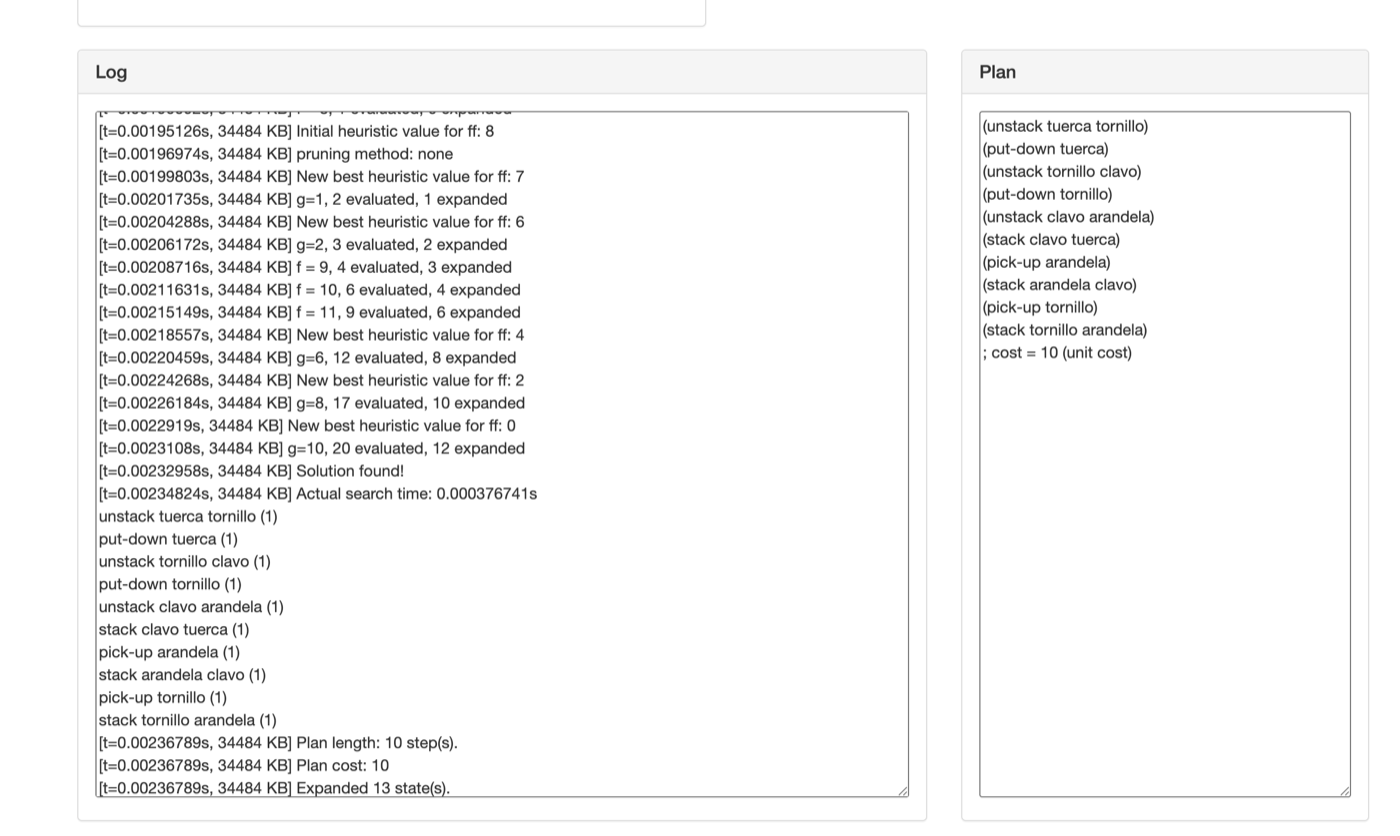
Un script Python (etapa2.py) écrit les fichiers PDDL du domaine et du problème avec une pile initiale et une pile cible aléatoires. Je n'ai pas écrit le planificateur : j'ai chargé les deux fichiers dans un solveur PDDL en ligne. Pour l'exemple des captures, il a renvoyé un plan de 10 étapes après avoir développé 13 états.
Étape 3 — Labyrinthe et navigation A*
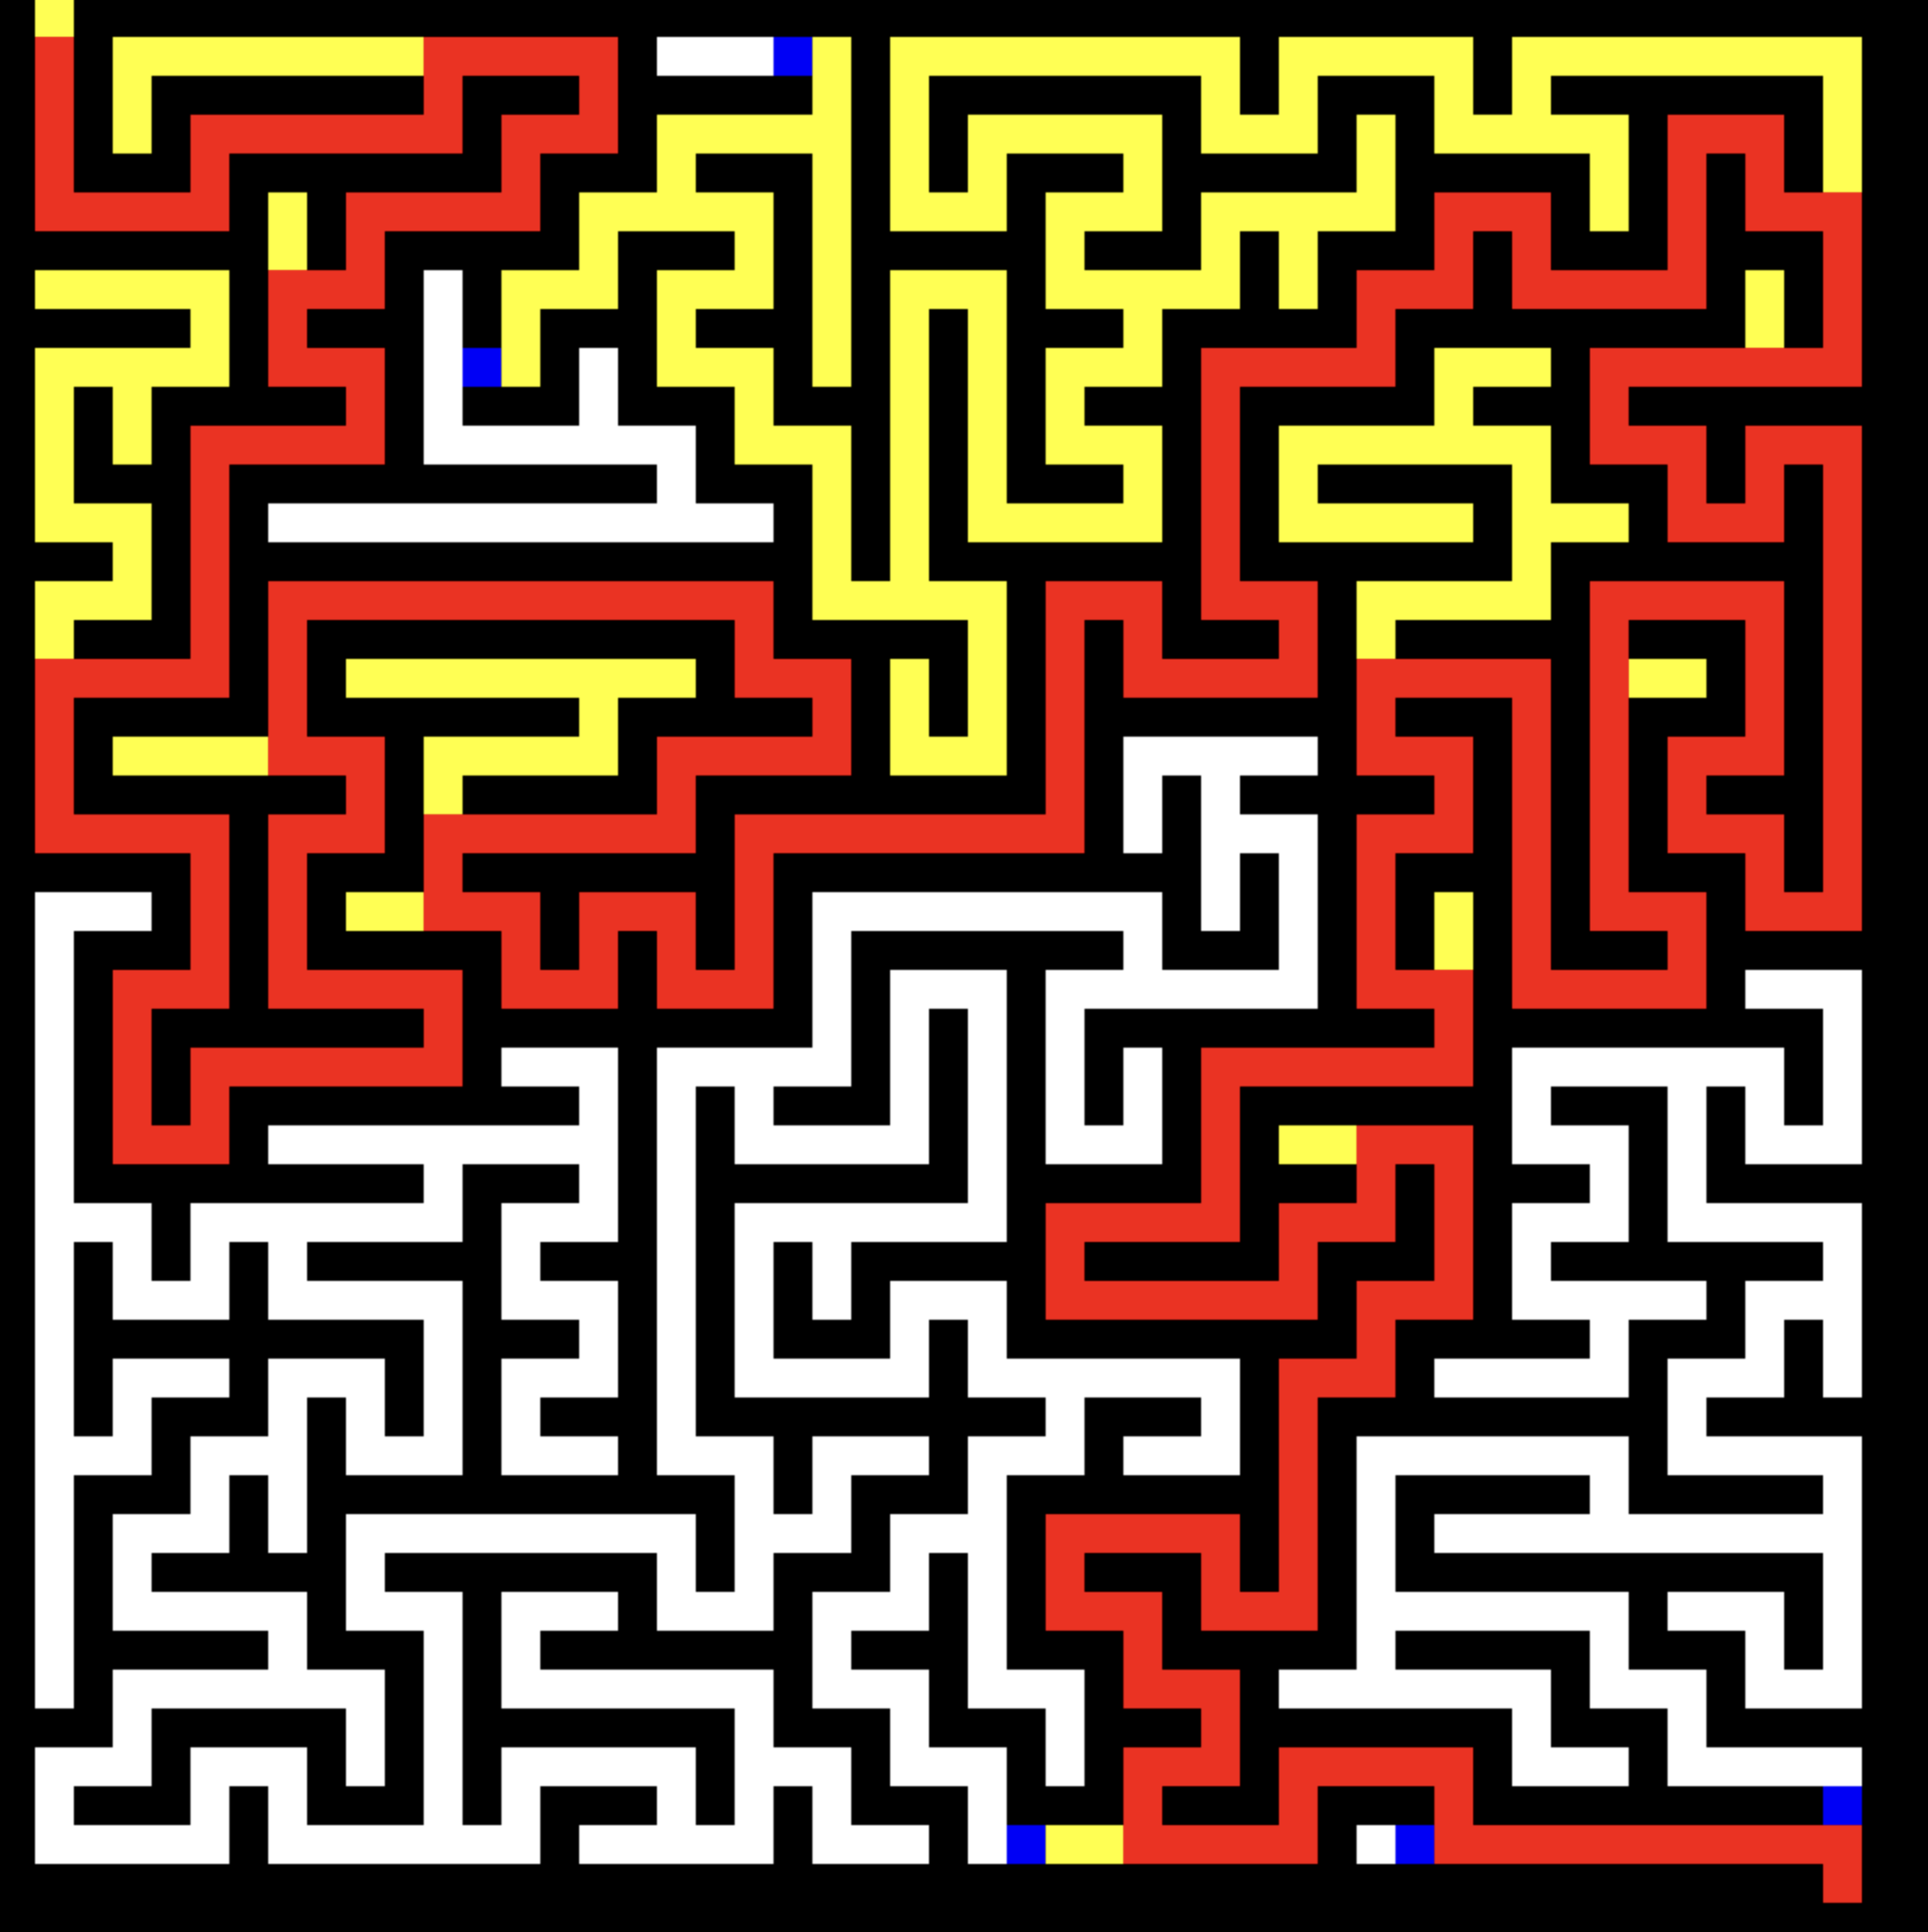
La salle est une grille 50×50 de cellules libres et de murs. Le labyrinthe est généré aléatoirement par creusement en profondeur, donc il existe toujours un chemin de l'entrée à la sortie.
A* s'exécute sur cette grille avec des déplacements dans quatre directions et la distance de Manhattan comme heuristique, avec une file de priorité (heapq). Une fenêtre pygame montre la recherche en direct derrière un bouton Start : cellules en attente en bleu, cellules explorées en jaune et chemin final en rouge. Le labyrinthe remplace la salle avec tables et chaises : c'est une simplification du problème réel.
Limites et améliorations
- L'étape de vision est réglée pour un montage contrôlé (carton vert, flash). Un autre fond demanderait une autre segmentation.
- Une précision parfaite sur quatre classes bien séparées, testée dans les mêmes conditions que l'entraînement, ne prouve pas la généralisation.
- Les trois étapes ne sont pas reliées entre elles et rien ne tourne sur un vrai robot : vision, planificateur et labyrinthe sont simulés séparément.
- Prochaine étape : alimenter le planificateur avec la sortie du classifieur et tester avec des photos sur d'autres fonds et éclairages.