Morfometría automatizada con IA y procesamiento de imágenes
Mi módulo del proyecto BlueRevolution (ENIB, Lab-STICC, Ifremer): máscaras hechas con SAM, imágenes sintéticas etiquetadas y una U-Net que separan nematodos y copépodos del detrito en fotos de microscopio, alimentando el pipeline de morfometría del equipo.
Proyecto de equipo de seis estudiantes. Construí el generador de datos sintéticos y el módulo de segmentación; el resto de la plataforma (detección de cola y esófago con YOLO, clasificadores de especie, color, textura y gónadas, morfometría y la app Streamlit) lo construyó el equipo.
- Python
- PyTorch
- PyTorch Lightning
- U-Net
- Segment Anything (SAM)
- OpenCV
- TorchMetrics
- TensorBoard
- Synthetic data
Objetivo
Los biólogos miden a mano cada nematodo y copépodo en fotos de microscopio (largo, ancho, cola, esófago) para estudiar cómo las presiones humanas y climáticas, como el dragado, la pesca y el calentamiento de los océanos, afectan a los suelos marinos. El organismo aparece mezclado con detrito, y anotar máscaras para entrenar un modelo lleva más tiempo que medir los animales. El objetivo de este módulo es entregar máscaras binarias del organismo, sin el detrito, que alimenten la extracción de características geométricas del equipo.
Estado inicial
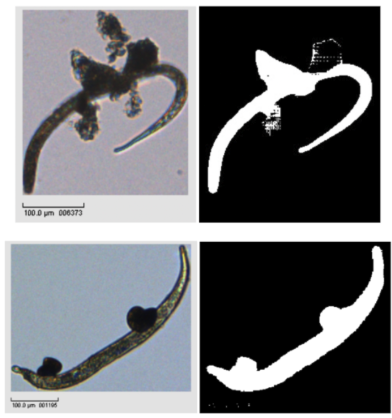
Las imágenes de microscopía suelen mezclar el organismo objetivo con detrito pegado. Los primeros pares imagen–máscara hicieron explícita esa ambigüedad: el modelo debe aprender una silueta limpia del organismo para que las características geométricas no se contaminen con residuos.
Hacer las máscaras con SAM
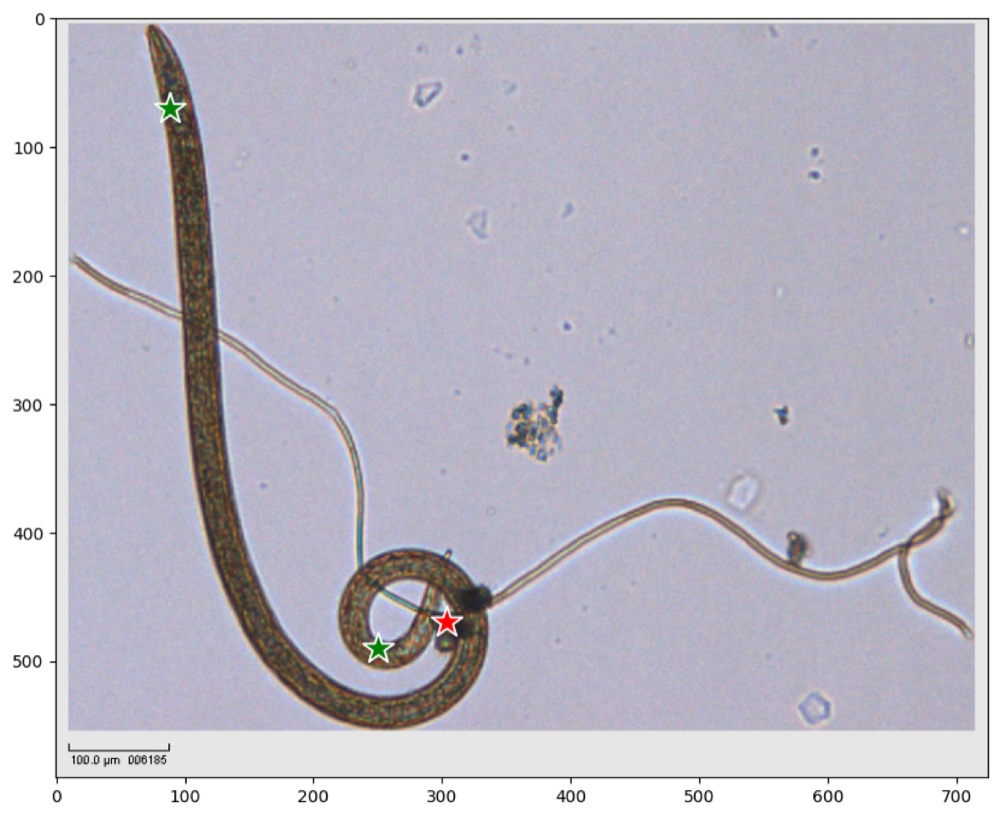
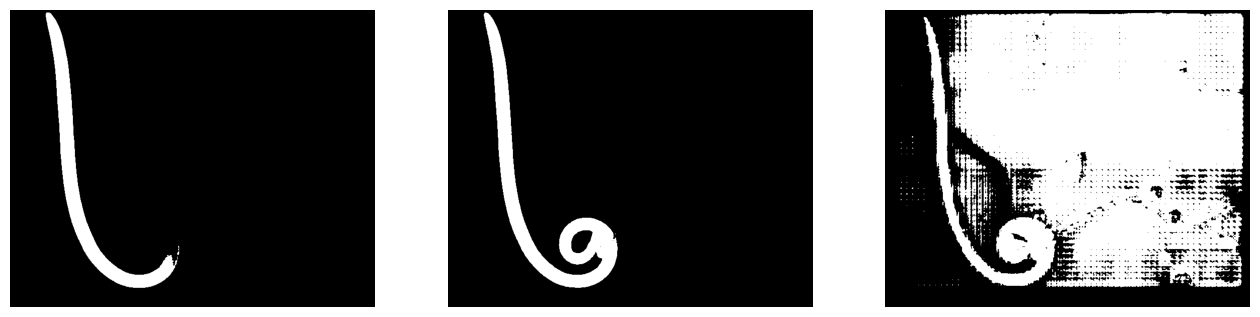
Dibujar las máscaras a mano era lo más lento, así que usé Segment Anything (SAM, ViT-H) como herramienta interactiva en un notebook de Colab. Para cada foto hago clic en uno a tres puntos: puntos verdes sobre el organismo y puntos rojos sobre el detrito que quiero dejar afuera. SAM propone tres máscaras candidatas, me quedo con la mejor y la guardo como etiqueta. Hacer esto sobre las fotos reales dio el conjunto de pares imagen–máscara sobre el que se apoya todo lo demás.
Dataset y datos sintéticos
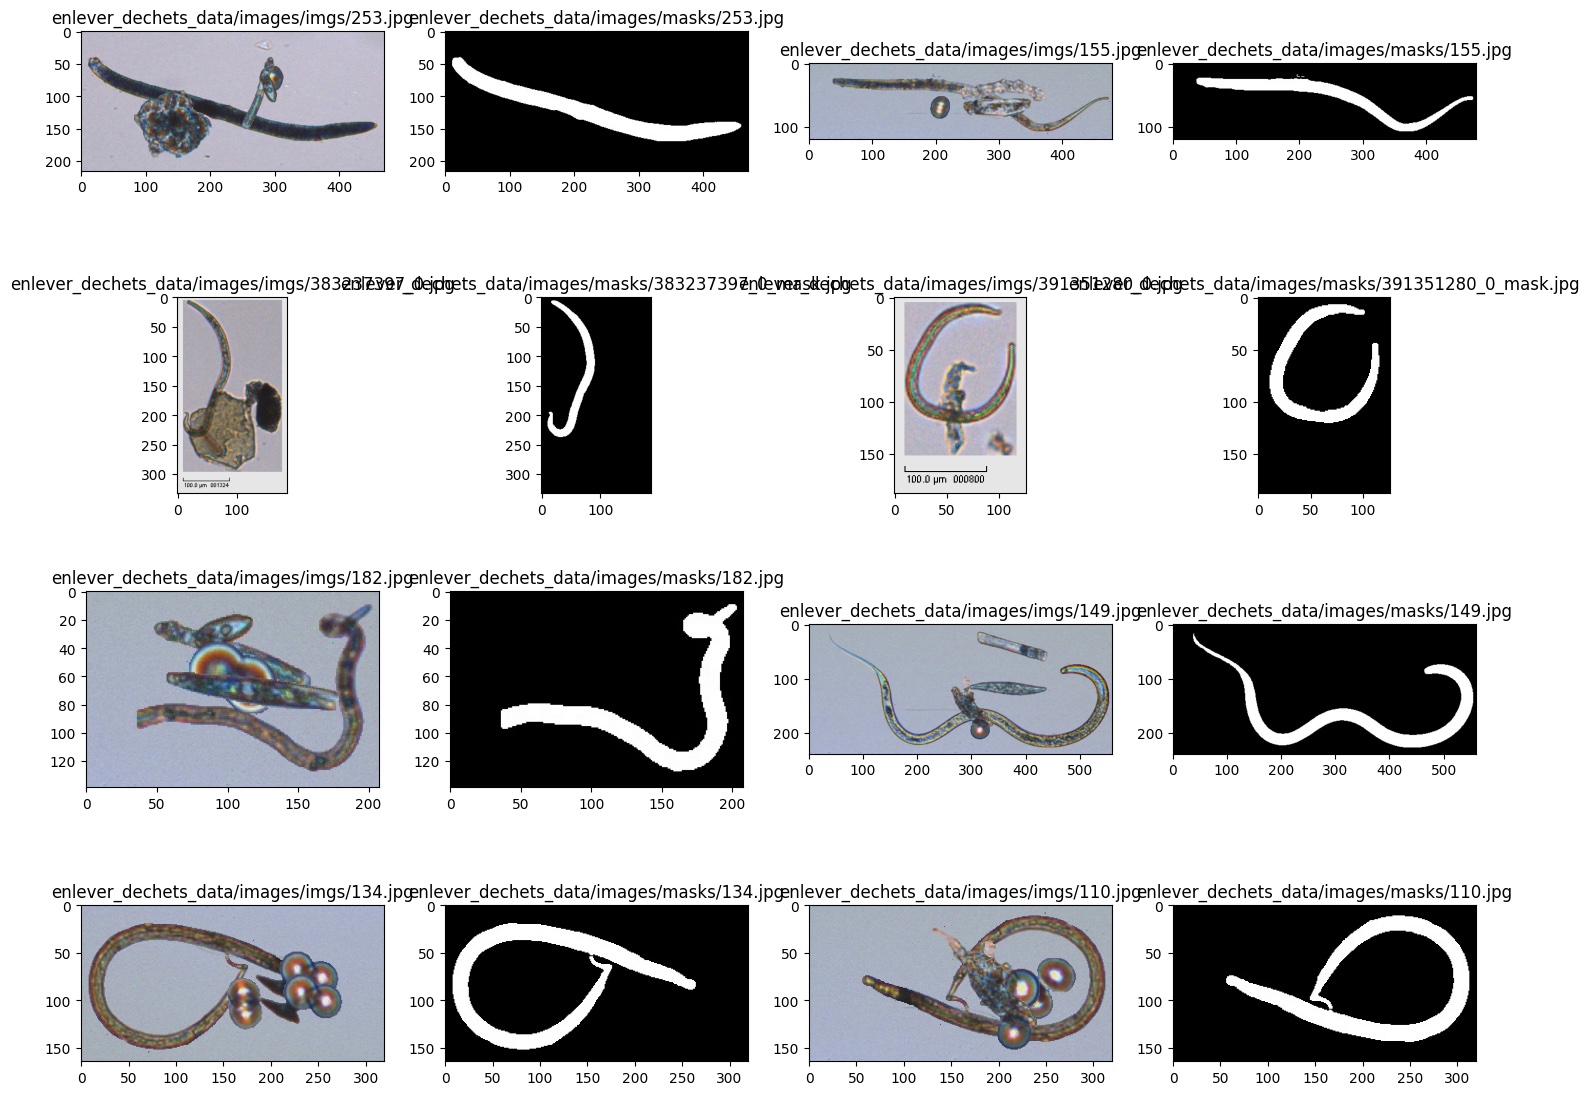
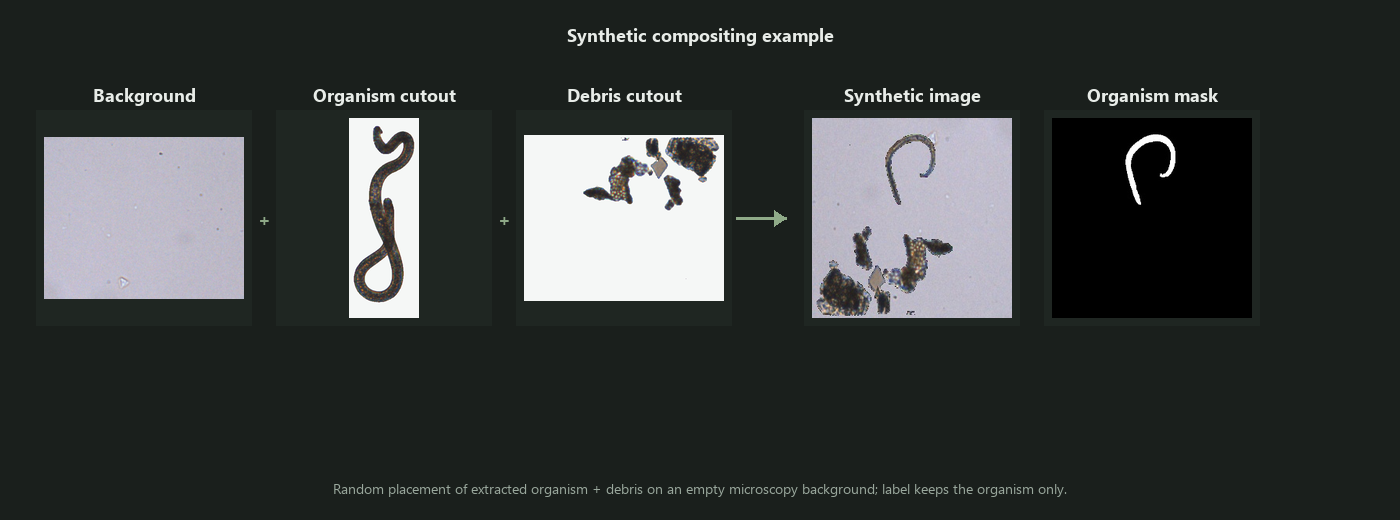
El resultado es un conjunto de imágenes de microscopía etiquetadas, máscaras binarias e imágenes de test reservadas, unos 100 pares reales en total. Para agrandar los datos de entrenamiento a partir de tan pocas fotos reales, un compositor en OpenCV recorta el animal con su máscara, lo coloca sobre un fondo de microscopio vacío, rota la escena y superpone dos o tres trozos de detrito al azar, produciendo unas 300 escenas sintéticas. Cada imagen viene con su máscara, lista para segmentar: blanco para el organismo, negro para el fondo y el detrito pegado. Para entrenar, imágenes y máscaras se redimensionan a 256×256.
La U-Net
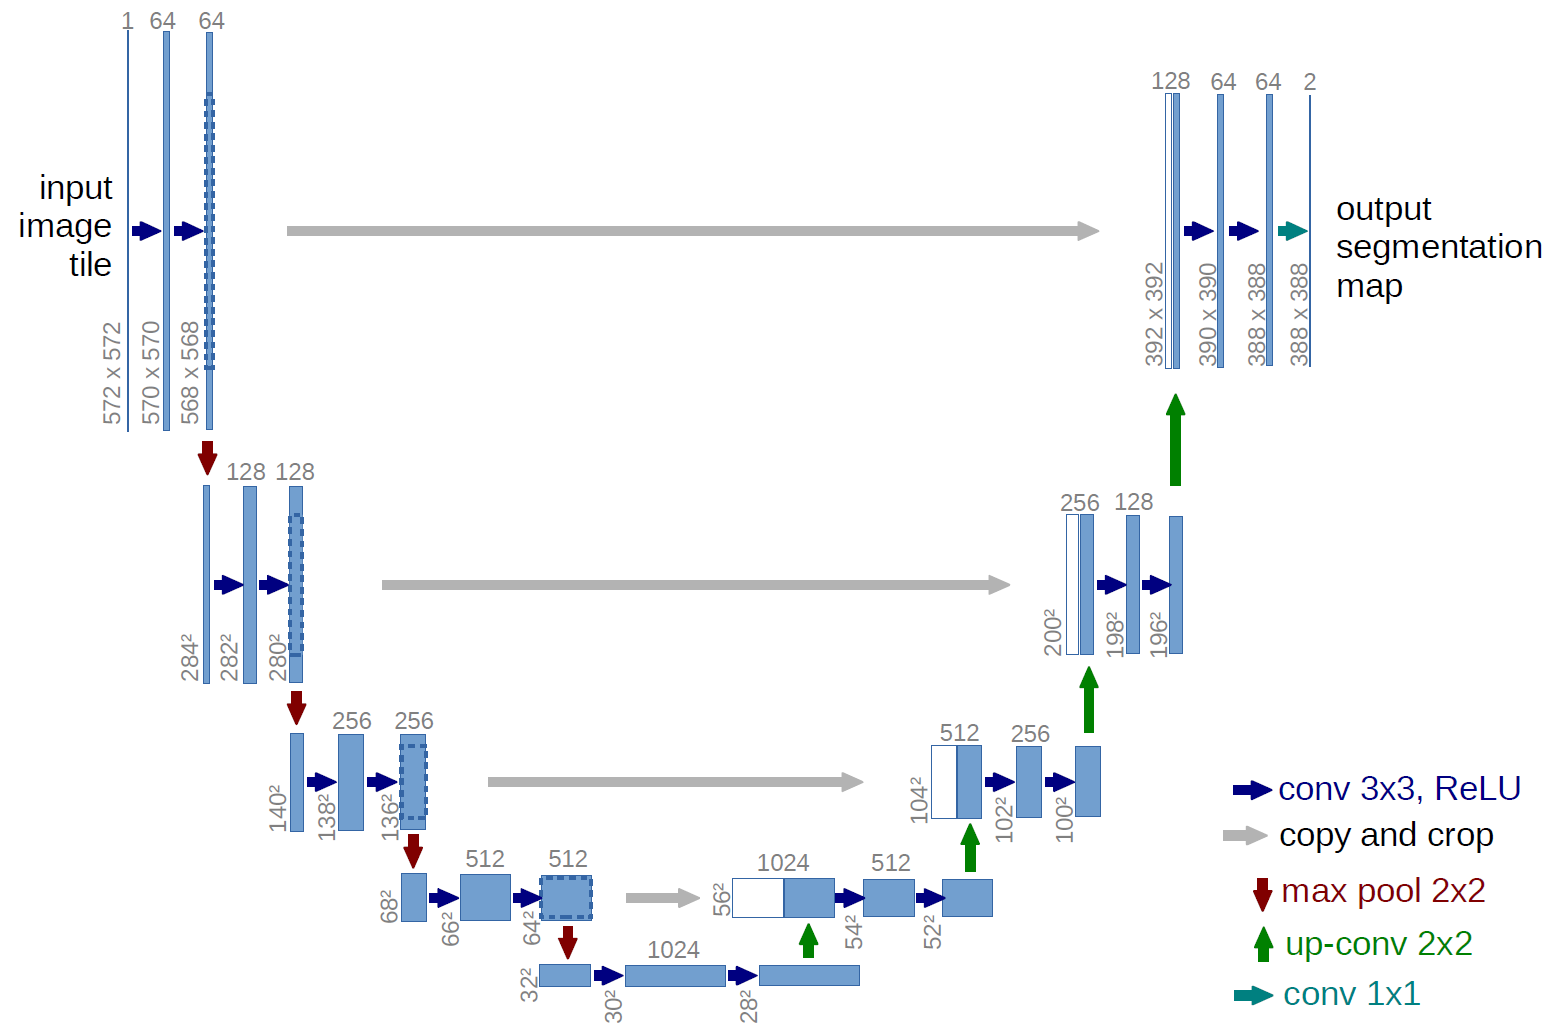
Construí la U-Net en PyTorch Lightning siguiendo la arquitectura estándar: cuatro bloques de reducción y cuatro de ampliación, cada uno con dos convoluciones con normalización por lotes y ReLU, conexiones de salto entre ellos, ampliación bilineal y una salida de un canal. Entrena con entropía cruzada binaria sobre los logits y Adam, con cosine annealing como mejor planificador de la tasa de aprendizaje y acumulación de gradientes para emular un batch más grande.
Un bloque de configuración al inicio del notebook (canales, tasa de aprendizaje, tamaño de batch, planificador, augmentation, RGB o escala de grises) permite cambiar un experimento en un solo lugar. El entrenamiento guarda el mejor checkpoint según la pérdida de validación, corta antes cuando deja de mejorar y registra pérdida, accuracy e IoU en TensorBoard. La inferencia devuelve la máscara al tamaño original de la foto.
Experimentos
Corrí 48 entrenamientos y los comparé en TensorBoard: RGB contra escala de grises, con y sin data augmentation, tamaños de batch de 2 a 32, con y sin las imágenes sintéticas, y el planificador de la tasa de aprendizaje (reducción en meseta y cosine annealing, entre las opciones de la configuración). También probé una U-Net con backbone preentrenado y una Mask R-CNN; las máscaras que se usan después salen de la U-Net simple.
Los ocho checkpoints que guardé rindieron muy parecido: pérdida de validación entre 0,113 y 0,120 e IoU de validación entre 0,66 y 0,71. El mejor según la pérdida de validación llegó a 0,113 con una accuracy de 0,955 y un IoU de 0,705 (época 193 de 314, planificador cosine). Abajo hay un dashboard interactivo con todos los runs: elegir runs, cambiar el suavizado y ordenar la tabla resumen.
Resultados
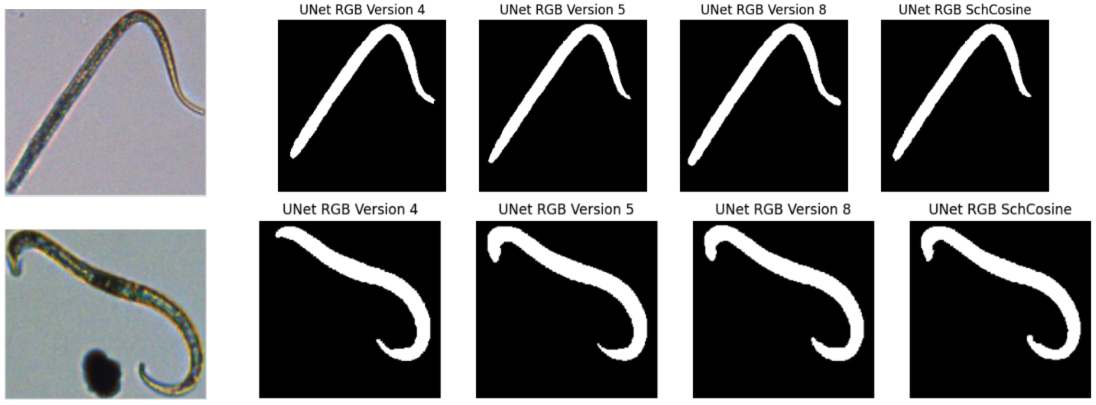
Se entregaron máscaras del organismo que distinguen el detrito, aptas para morfometría automatizada. Las comparaciones lado a lado de checkpoints sobre imágenes de test mostraron que los mejores entrenamientos aíslan al microorganismo y dejan fuera de la máscara los residuos pegados, con lo que el resto del equipo recibe al organismo ya separado del fondo.
Límites
- El puntaje de validación probablemente es optimista: la validación es un split aleatorio 80/20 de imágenes reales y sintéticas mezcladas, no un conjunto reservado solo de fotos reales.
- El F1 de validación nunca se registró; las curvas y la tabla informan pérdida, accuracy e IoU.
- Solo unos 100 pares reales, así que las imágenes sintéticas son una parte grande de los datos de entrenamiento.
- Las configuraciones difieren poco, así que no leería el ranking de los runs como significativo.
- Mi módulo termina en las máscaras; la detección de cola y esófago, la clasificación y las mediciones las hizo el resto del equipo.